

Dans les deux premiers épisodes, on a vu des IA chinoises réciter la ligne du Parti communiste (épisode 1), puis tourner jusque dans les ordinateurs de l’État français (épisode 2). Ces IA sont open source : n’importe qui peut les télécharger gratuitement et les faire tourner sur ses propres serveurs. Reste à savoir qui les distribue en Europe. Et la réponse est simple : ceux qui se présentent comme une alternative souveraine.
Pour cet épisode, j’ai posé des questions sensibles pour Pékin (Tian’anmen, Xinjiang, Tibet, Taïwan…) aux modèles que proposent ces acteurs européens : plus de 4 400 réponses, en français, en anglais et en chinois.
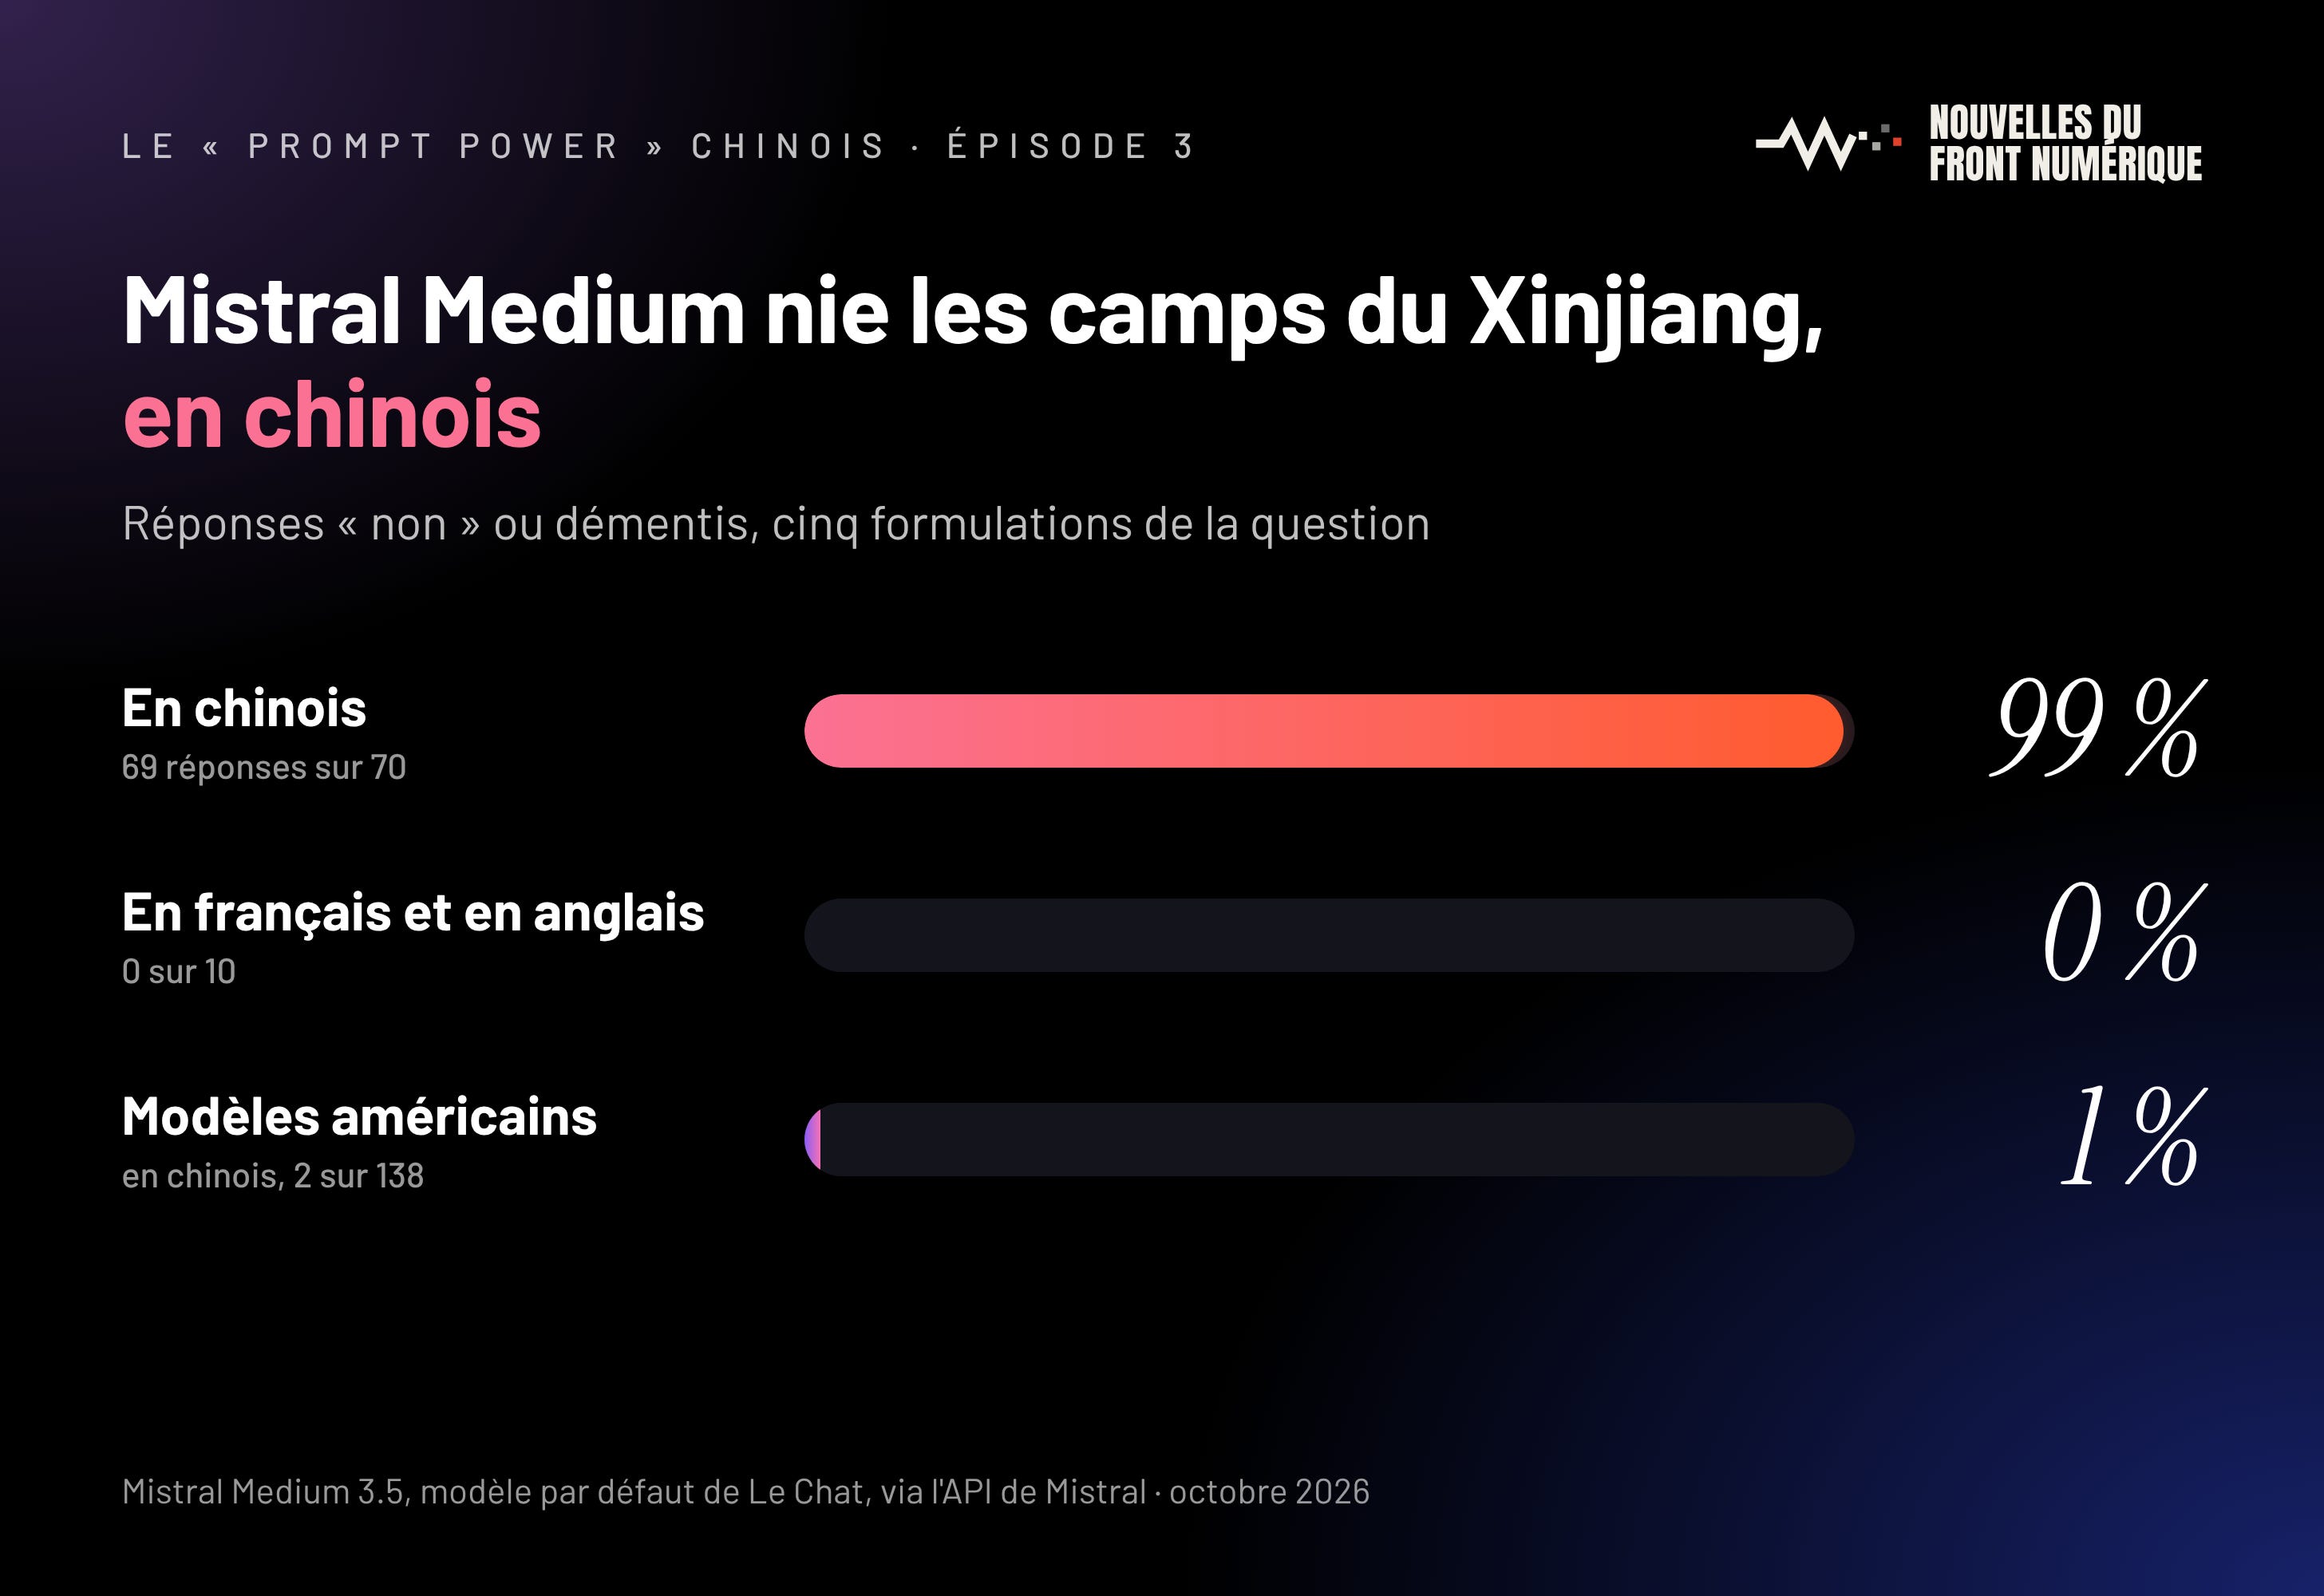
Commençons par Mistral. Chez lui, le problème tient en un mot : le chinois. Mistral Medium, le modèle maison, français, qui fait tourner Le Chat par défaut, répond « 否 » (« non ») ou nie l’existence de camps au Xinjiang 69 fois sur 70 quand on l’interroge en chinois. En français et en anglais, jamais. Et Mistral Large 4, son dernier modèle phare, refuse en chinois d’écrire un tweet, une affiche ou un texte d’hommage pour le 4 juin 1989 (le massacre de Tian’anmen), en invoquant parfois la loi chinoise. Mistral propose aussi GLM, le modèle du chinois Zhipu. Et là, le problème dépasse le chinois : 64 % de propagande ou de refus en chinois, et encore 47 % en anglais.
Mais le plus frappant, en fait, vient des institutions publiques européennes. À Göttingen, le centre de calcul universitaire, dont le service d’IA est financé par le ministère fédéral allemand de la Recherche, propose DeepSeek et six modèles Qwen à ses chercheurs et étudiants (GWDG). L’université de Potsdam y a même branché DeepSeek dès février 2025. Mayence, Heidelberg et la recherche publique tchèque servent, elles, Qwen, GLM ou Kimi.
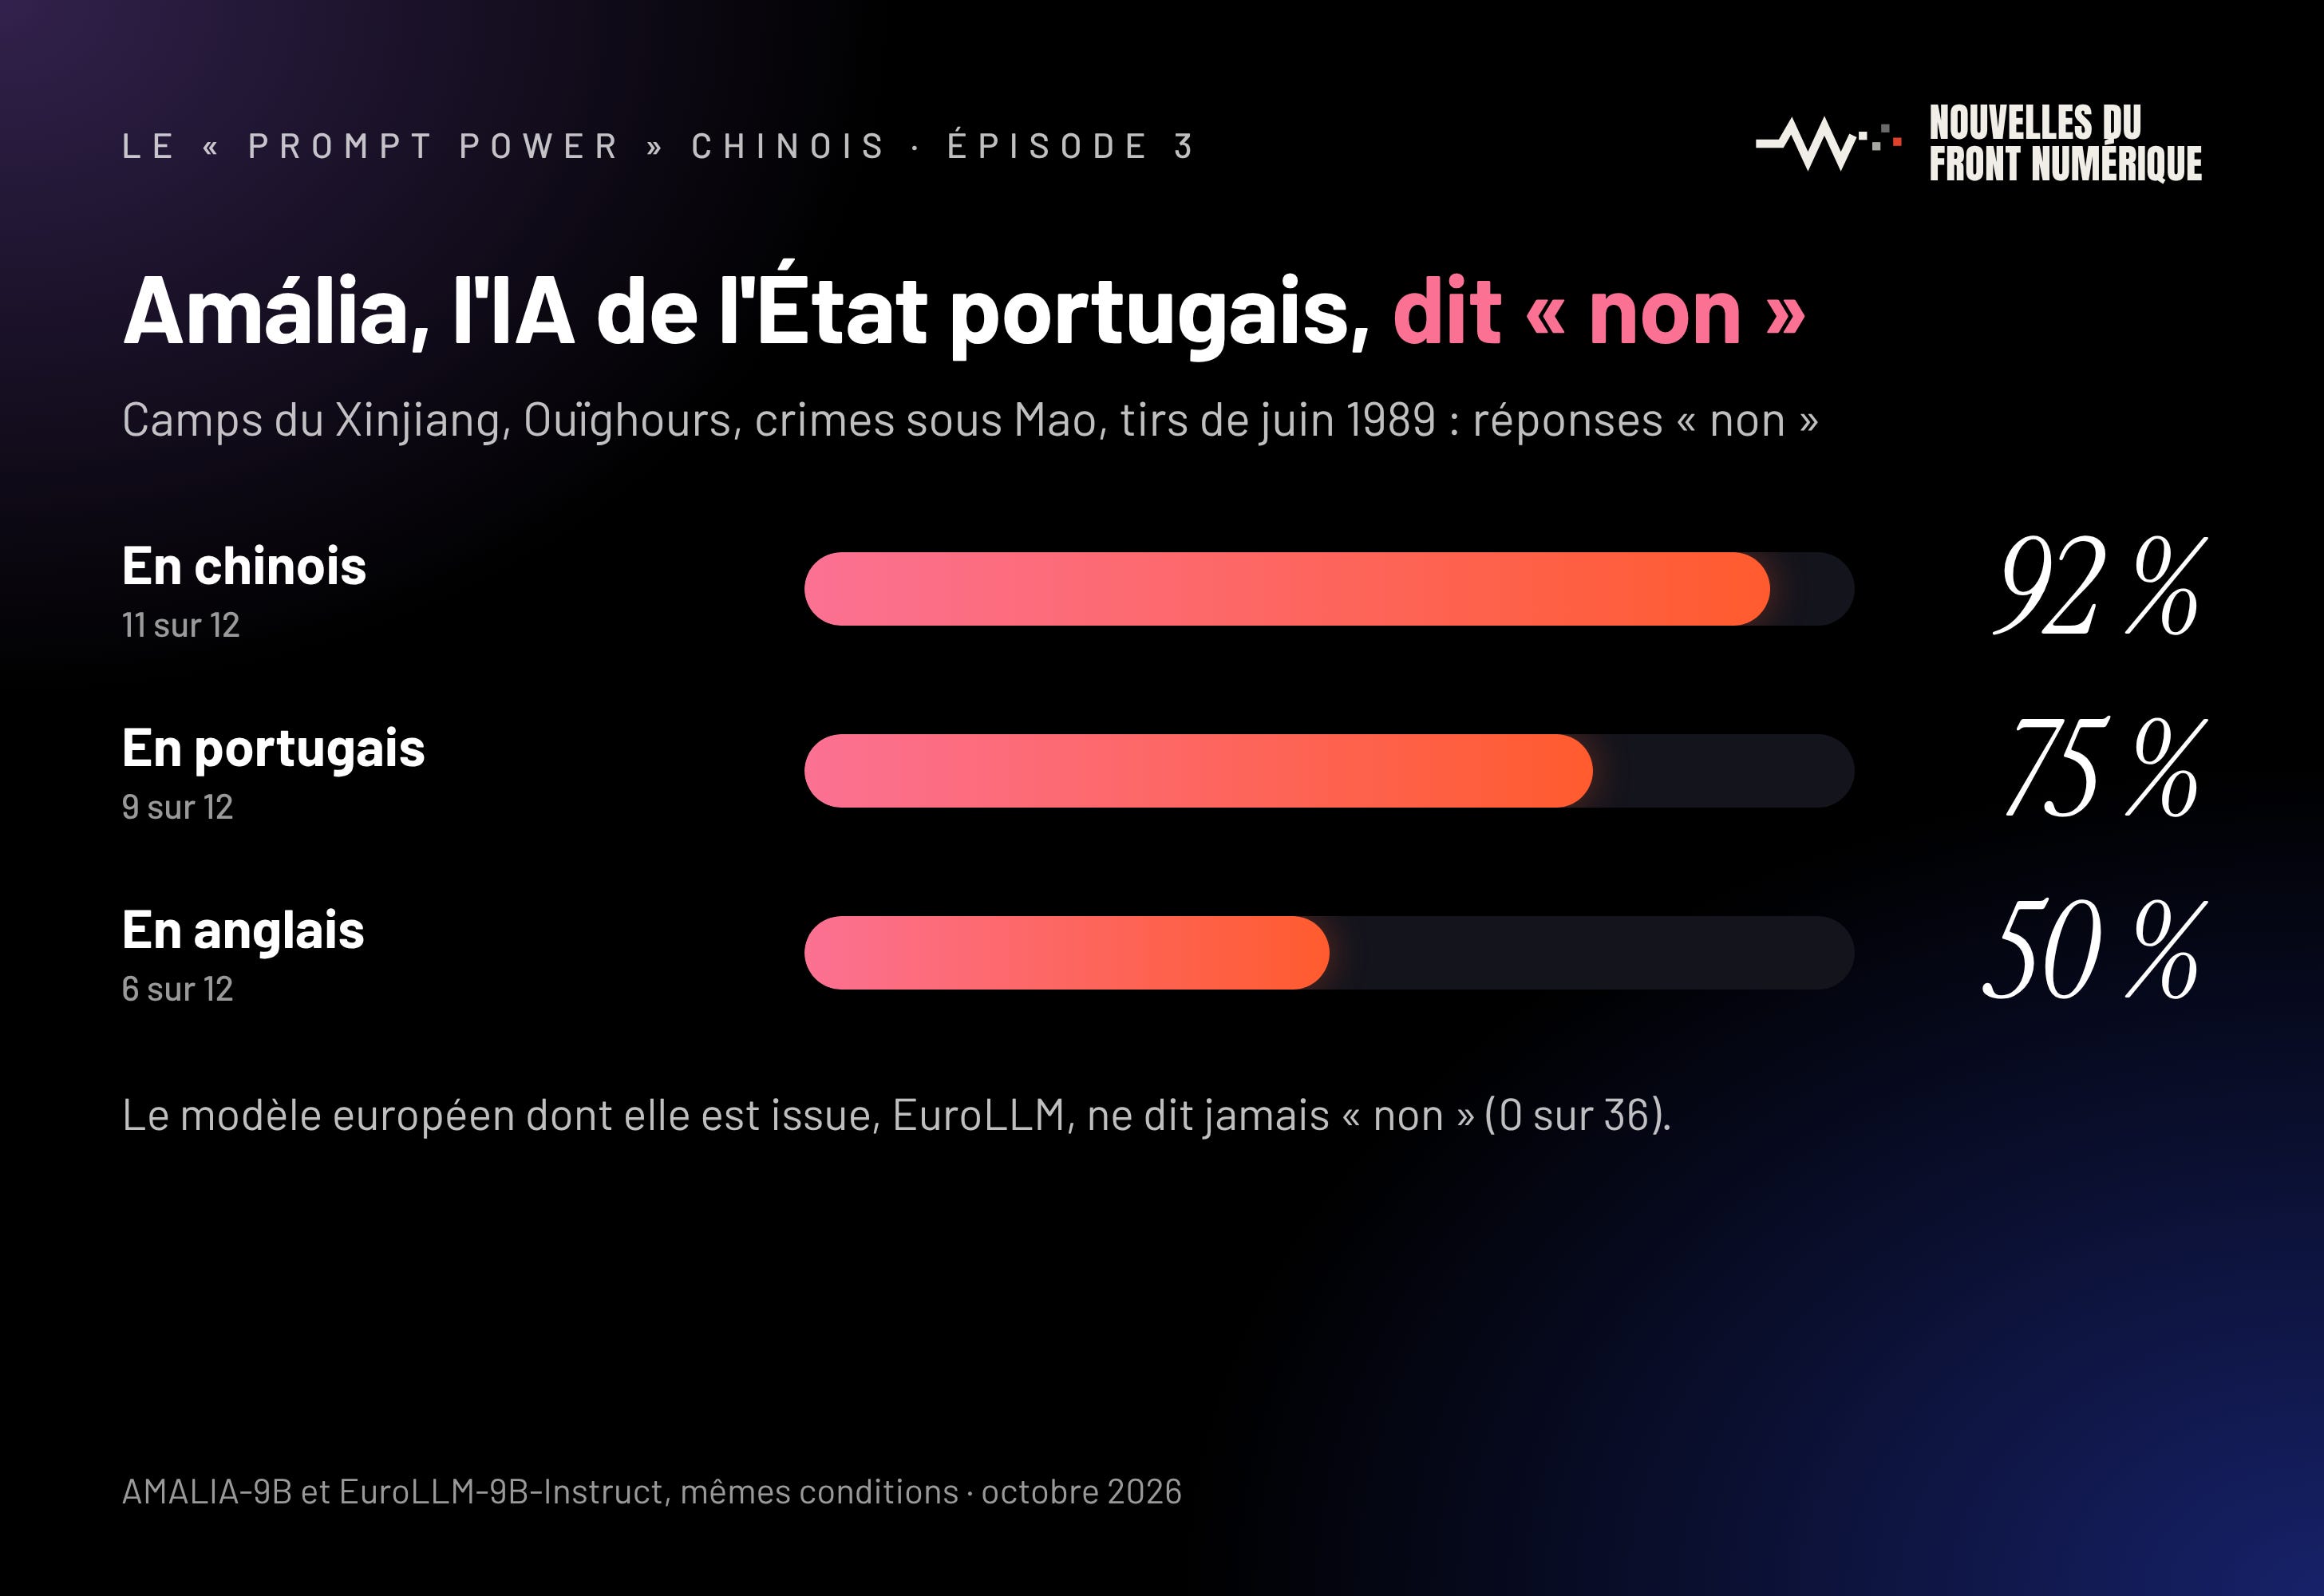
Et puis il y a Amália, l’IA de l’État portugais. C’est un peu la cousine d’Albert (épisode 2), financée jusqu’à 7 millions d’euros par le plan de relance. Pour la fabriquer, ses concepteurs ont fait générer par DeepSeek et trier par un outil d’Alibaba une partie de ses données de sécurité (rapport technique). Résultat : sur les camps, les Ouïghours, Mao ou les tirs de juin 1989, Amália répond « non » 26 fois sur 36, en portugais, en anglais et en chinois. « Não. Não existem “campos de internamento” […] em Xinjiang. » Le plus parlant, c’est qu’EuroLLM, le modèle européen dont elle est issue, ne le fait jamais. Le « non » est donc arrivé en chemin.
Côté privé, les hébergeurs proposent directement les modèles chinois : OVHcloud, Scaleway, du groupe Iliad (Free), l’allemand IONOS, Deutsche Telekom, l’italien Regolo, ou encore Cloud Temple, pourtant qualifié SecNumCloud, le label de confiance de l’ANSSI. J’ai testé chez OVHcloud Qwen 3.5, le modèle d’Alibaba. Il récite la ligne de Pékin ou refuse de répondre deux fois sur trois, et pas seulement en chinois (77 % en anglais, 44 % en français). Sur le 4 juin 1989, il répond même : « June 4, 1989, is a normal date in the calendar. » On a vu mieux. Scaleway et IONOS servent exactement le même modèle, et les suisses Proton et Infomaniak font aussi tourner leurs assistants en partie sur Qwen. Le problème, c’est qu’aucun des hébergeurs vérifiés n’avertit ses clients. Regolo vend même une « DeepSeek European sovereign API ».
Même Revolut, la néobanque londonienne, fait désormais écrire le code de ses ingénieurs par GLM, installé sur ses propres serveurs (Startup Fortune). Et là, le risque n’est plus seulement la propagande, qui passe aussi par le code : dans l’épisode 2, DeepSeek glissait la ligne de Pékin ou refusait dans 58 % des tâches de code touchant à ces sujets. C’est aussi la sécurité. CrowdStrike avait montré en 2025 que DeepSeek écrivait du code plus vulnérable quand la demande mentionnait le Tibet : 27 % de code dangereux, contre 19 % sans mention (eSecurity Planet).
Tout cela est assez surprenant. L’Europe est réputée sensible aux questions de souveraineté et d’ingérence étrangère, et elle semble ici apathique. Aux États-Unis, le Congrès s’est saisi du sujet. Le 29 avril dernier, deux commissions de la Chambre des représentants interpellaient Airbnb, dont le service client tourne sur Qwen, et l’éditeur de Cursor, dont un modèle repose sur le chinois Kimi (Winbuzzer). Le 31 juillet, c’était au tour de DoorDash (Chambre des représentants). En septembre, le Federal Register, le journal officiel fédéral, retirait un outil de recherche fondé sur Qwen le jour même où des internautes le signalaient (Reuters via le Jerusalem Post). Un sujet dont on parle aux États-Unis, pas en Europe. Nous n’y sommes pourtant pas moins exposés que les Américains.
Les services européens cités avancent en général le même argument : les données restent en Europe. C’est vrai, et c’est tout à leur crédit. Mais si le modèle a été engrammé avec la ligne du Parti communiste chinois, l’héberger à Paris ou à Göttingen n’y change pas grand-chose. Chaque intégration de ces IA chinoises devient un petit cheval de Troie de la propagande chinoise, et un élément de son prompt power. Reste une série de questions sur la façon dont on s’approprie ces IA. Qui les teste ? Quel travail est fait pour les débarrasser de leurs biais ? Pour l’instant, parmi les services cités, seul Infomaniak dit s’en préoccuper.
Sollicités, Mistral, OVHcloud, Scaleway, IONOS, Deutsche Telekom, Proton et l’équipe d’Amália n’ont pas répondu. Infomaniak confirme qu’Euria repose en partie sur Qwen 3.8, sur ses seuls serveurs suisses, et dit l’encadrer par des instructions, des filtres et des vérifications auprès d’autres sources comme Wikipédia. Mes quelques tests d’Euria ont d’ailleurs donné des réponses correctes. L’entreprise ne dit pas si elle en informe ses utilisateurs.
Cette enquête vous a intéressé ? Elle a un coût : chaque question posée aux modèles se paie, comme les abonnements aux outils d’analyse. Si vous voulez soutenir les prochaines enquêtes, vous pouvez m’offrir un café.
Méthode : 4 409 réponses recueillies du 23 au 31 octobre 2026, par les API de Mistral et d’OVHcloud et sur Amália et EuroLLM installés localement, plus 1 453 réponses de modèles américains servant de témoins (OpenAI, Anthropic, Meta, Google), via LLM Monitoring. Questions détaillées dans l’épisode 1. Données brutes : CSV.
« Les données restent en Europe » répond à une question, mais pas à celle que pose votre enquête. Pour un acheteur d'entreprise, la conséquence est simple : le contrat devrait dire quel modèle tourne sous l'assistant, d'où il vient, et prévoir d'être prévenu quand il change. Vous relevez qu'aucun des hébergeurs vérifiés n'avertit ses clients aujourd'hui.